Automação de CAPTCHA para Big Data: Colete Dados em Larga Escala com Eficiência
No cenário dinâmico e orientado por dados de 2025, a automação de CAPTCHA para big data deixou de ser um luxo e se tornou uma necessidade crítica. CAPTCHAs (Testes de Turing Públicos Completamente Automatizados para Diferenciar Computadores de Humanos) funcionam como guardiões, protegendo sites contra bots, spam e acessos não autorizados. No entanto, para especialistas de TI, analistas de dados e engenheiros envolvidos em projetos de scraping em larga escala, os CAPTCHAs representam um grande desafio. Eles interrompem pipelines automatizados, atrasando processos críticos para insights em tempo real em setores como e-commerce, finanças, imóveis e inteligência competitiva.
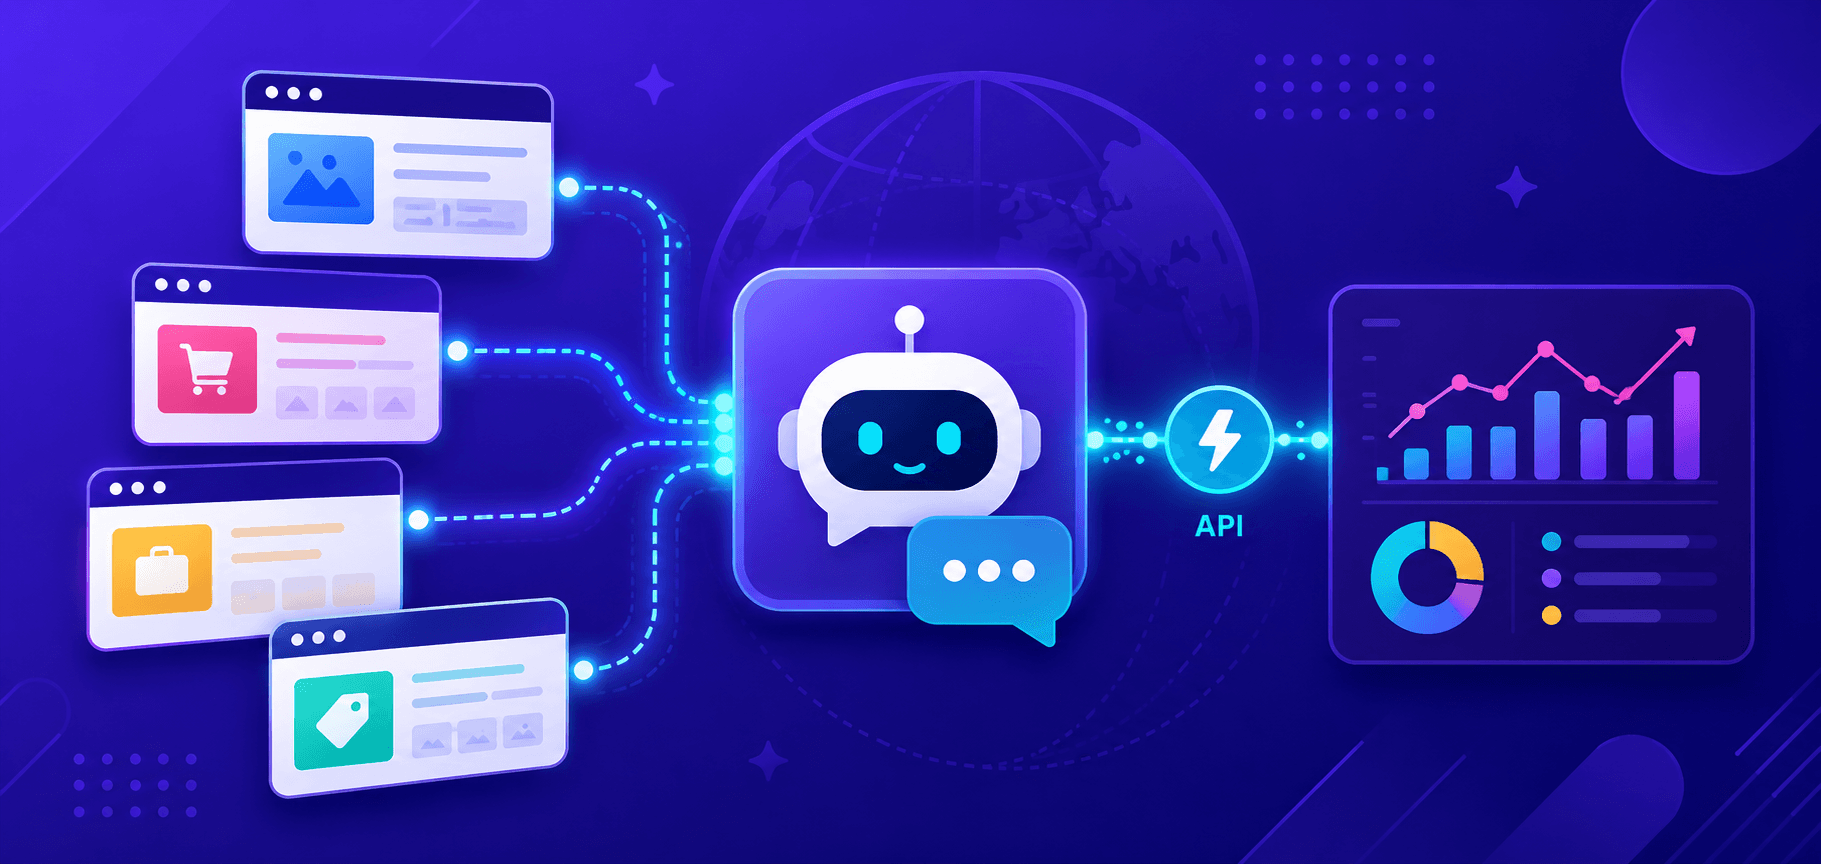
O web scraping impulsiona o big data ao extrair grandes volumes de dados — preços de produtos, avaliações de clientes, tendências de mercado ou registros públicos. Mas os CAPTCHAs, com seus quebra-cabeças visuais, pontuações comportamentais e desafios adaptativos, criam gargalos que travam os scrapers, causam timeouts ou exigem intervenções manuais dispendiosas. Para projetos que processam milhões de registros por dia, resolver CAPTCHAs manualmente é inviável, causando atrasos, conjuntos de dados incompletos e menor retorno sobre investimento (ROI). A automação de CAPTCHA para big data soluciona isso ao permitir extração de dados fluida e escalável, garantindo pipelines eficientes e resilientes.
Este artigo explora a fundo os desafios que os CAPTCHAs impõem aos fluxos de trabalho de big data, apresenta serviços anti-CAPTCHA e suas integrações, além de estratégias práticas de implementação. Através de casos reais e insights técnicos, mostramos como a automação de scraping supera as barreiras impostas por CAPTCHAs, permitindo fluxos de dados mais rápidos e confiáveis. Seja para monitorar preços de concorrentes ou agregar dados financeiros em tempo real, a resolução de CAPTCHA é fundamental para manter-se competitivo.

Desafios na Coleta de Dados
CAPTCHAs são pilares da segurança na web, projetados para distinguir humanos de bots. Eles protegem sites contra spam, ataques de força bruta e scraping não autorizado. Para projetos de big data, no entanto, CAPTCHAs são um obstáculo significativo. Resolver CAPTCHA geralmente se torna o primeiro gargalo técnico, interrompendo fluxos automatizados e fazendo com que os scrapers parem, repitam ou falhem completamente.
A evolução dos CAPTCHAs reflete a corrida entre desenvolvedores de bots e engenheiros de segurança. Os primeiros usavam texto distorcido, mas os sistemas modernos aplicam IA, análise comportamental e desafios multimodais. Isso torna a resolução de CAPTCHAs como reCAPTCHA cada vez mais complexa, exigindo soluções avançadas para manter a eficiência na coleta de dados.
Tipos de CAPTCHA
Os CAPTCHAs atuais são diversos e adaptáveis, projetados para detectar até os bots mais sofisticados:
reCAPTCHA v2: Caixa de seleção (“Não sou um robô”) e tarefas visuais como identificar faixas de pedestres, semáforos ou vitrines. Exigem reconhecimento visual e interação humana.
reCAPTCHA v3: CAPTCHA invisível que pontua o comportamento do usuário com base em movimentos do mouse, padrões de clique, reputação do IP e histórico de navegação, sem desafios explícitos.
Quebra-cabeças em grade de imagens: Tarefas como “selecionar todos os quadrados com bicicletas” exigem classificação de imagens em tempo real.
CAPTCHAs de áudio: Exigem transcrição de frases faladas, geralmente como alternativa a desafios visuais.
CAPTCHAs comportamentais: Analisam movimentos do cursor, ritmo de digitação e padrões de rolagem para detectar comportamento não humano, muitas vezes com pontuação invisível.
Esses sistemas usam aprendizado de máquina para ajustar a dificuldade com base na reputação do IP ou comportamento do usuário. Por exemplo, muitos acessos de um único IP podem acionar desafios mais difíceis — motivo pelo qual a automação de CAPTCHA é essencial para a escalabilidade no big data.
Impacto nos Fluxos de Trabalho de Big Data
Os CAPTCHAs impactam os pipelines de big data de várias maneiras:
Menor Taxa de Coleta: Scrapers travam ou expiram ao encontrar CAPTCHAs, atrasando insights.
Custos Elevados: Intervenção manual ou infraestrutura ociosa consome recursos.
Lacunas de Dados: Interrupções causam conjuntos de dados incompletos, comprometendo a análise.
Limites de Escalabilidade: Sem automação, lidar com milhões de requisições se torna inviável.
Exemplo: uma empresa de e-commerce monitorando preços de concorrentes em milhares de sites pode ter seu pipeline paralisado por CAPTCHAs a cada poucas centenas de acessos, impactando a inteligência de mercado. Agregadores imobiliários enfrentam o mesmo ao coletar dados de portais locais. Nestes casos, a automação da resolução de CAPTCHA é vital.
Soluções de Automação
O Que é Automação de CAPTCHA?
Envolve o uso de ferramentas ou serviços especializados que resolvem CAPTCHAs automaticamente, permitindo que o scraping continue sem interrupção. Essas soluções imitam ações humanas ou usam IA para interpretar e resolver desafios — desde quebra-cabeças visuais até pontuações comportamentais.
Essencial para scraping em larga escala, a automação evita pausas para intervenção humana: o scraper envia o CAPTCHA ao serviço, recebe a solução (token ou texto) e continua o processo com mínima latência.
Serviços Anti-CAPTCHA para Big Data
CapMonster Cloud: Serviço baseado em nuvem com suporte a reCAPTCHA v2/v3, imagem para texto e muito mais. Destaques:
Resolução rápida (3–7 segundos em média).
Emulação de navegador para interação realista.
Gerenciamento dinâmico de tarefas para alto volume.
Versão auto-hospedada para privacidade e economia.
Como Funciona
Serviços anti-CAPTCHA combinam várias tecnologias:
Aprendizado de Máquina: Modelos de IA analisam imagens, áudios ou padrões comportamentais para gerar respostas.
Solucionadores Humanos: Em desafios complexos, humanos em redes distribuídas respondem em segundos.
APIs: Um CAPTCHA API para scraping permite enviar o desafio (sitekey, URL, imagem) e receber a resposta (token ou texto).
Integração com Frameworks de Scraping
Browsers sem interface como Puppeteer, Playwright ou Selenium são ideais para scraping com manipulação de CAPTCHA. Etapas-chave:
Detecção de CAPTCHA: Verificação por HTML (ex:
div#g-recaptcha), triggers JS ou respostas de rede (403 com payload).Integração com API: Envie o CAPTCHA para o solver e receba a resposta. Suporte para múltiplas threads é comum.
Injeção da Solução: Insira o token ou texto retornado na página ou requisição.
Gerenciamento de Sessões: Armazene cookies, tokens e user-agent para manter a continuidade.
Exemplo: um script Puppeteer detecta um reCAPTCHA v2, envia o sitekey para o CapMonster, recebe o token e o insere no callback da página — tudo em 5 a 10 segundos.
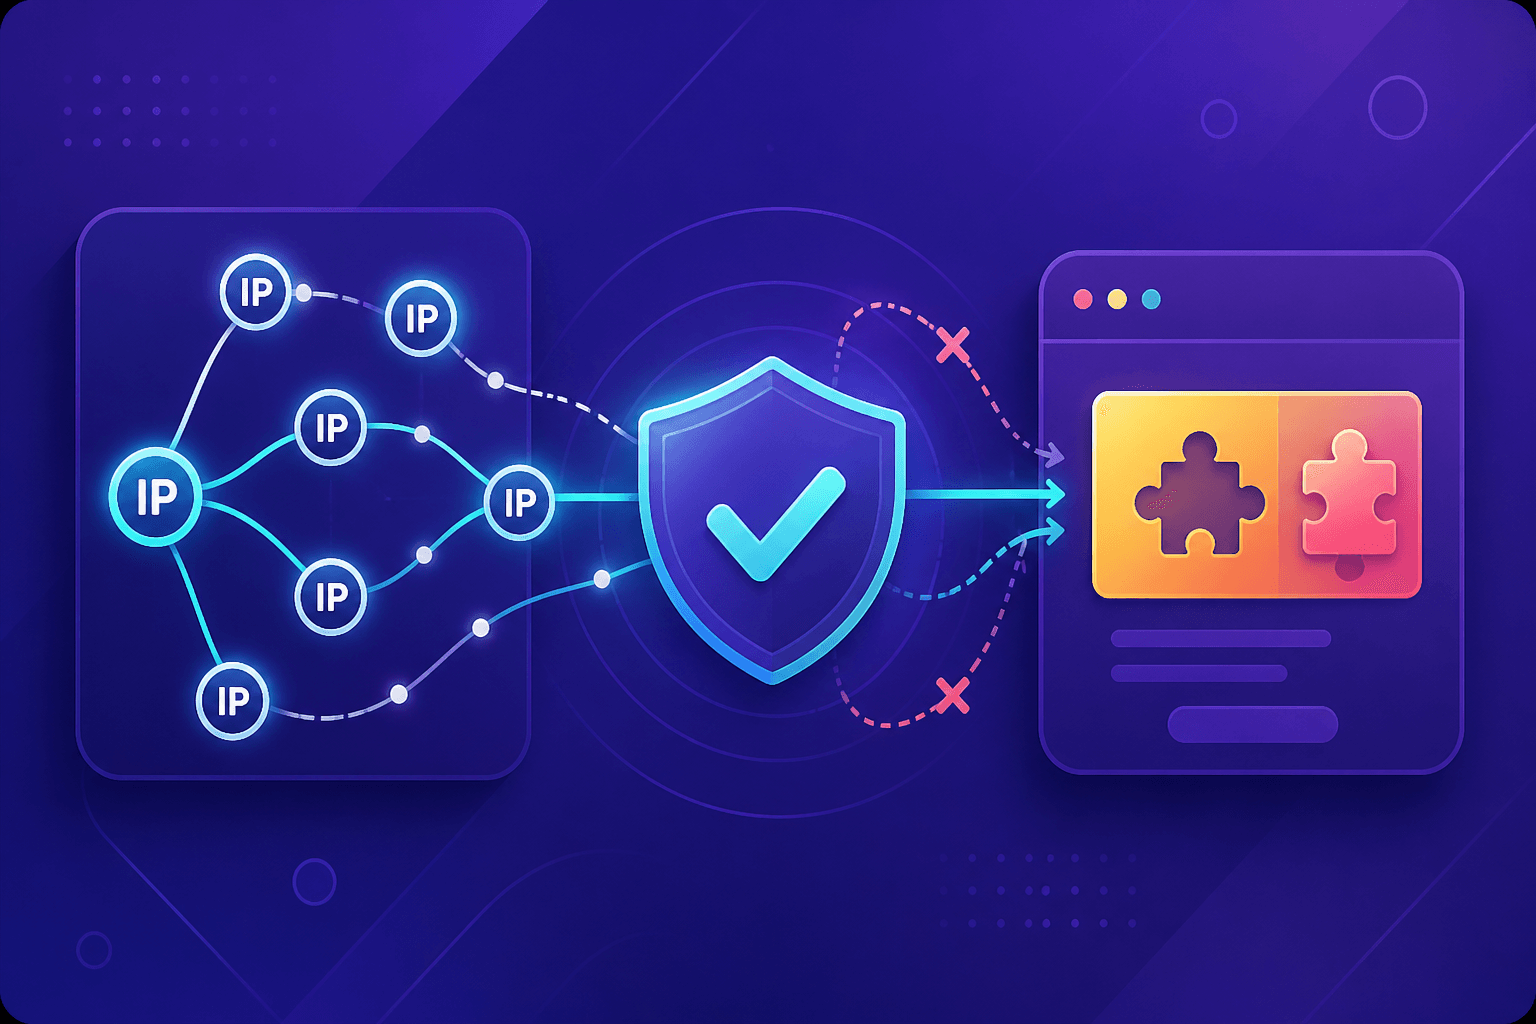
Rotações de Proxy e IP
A reputação do IP afeta a dificuldade do CAPTCHA. Boas práticas:
Proxies residenciais: IPs com alta confiança.
Rotação de IPs: A cada 100–500 requisições.
Monitoramento de Proxies: Troque IPs banidos automaticamente.
Fingerprints de dispositivos: Varie user-agents, headers e viewport.
Um bom gerenciamento de proxy é essencial para eficiência mesmo sob alta densidade de CAPTCHAs.
Filas e Escalabilidade
Sistemas como RabbitMQ, Kafka ou Redis organizam a resolução de CAPTCHAs em larga escala. Cada tarefa inclui:
Tipo de CAPTCHA.
Metadados (sitekey, URL, proxy).
Prioridade.
Contagem de tentativas.
Isso desacopla scraping da resolução, mantendo a responsividade.
Riscos a Considerar
Apesar da eficiência, há riscos legais, técnicos e financeiros:
Legais: Scraping pode violar termos de uso ou leis como GDPR. Respeite o
robots.txte evite dados pessoais.Detecção: Fingerprinting avançado exige stealth plugins e IPs rotativos.
Segurança: Compartilhar dados com terceiros pode vazar informações. Prefira APIs criptografadas ou soluções auto-hospedadas.
Custo: Resolver milhões de CAPTCHAs pode ser caro. Otimize eliminando desafios duplicados e priorizando soluções locais.
Use ferramentas como Grafana ou Prometheus para monitorar taxas de sucesso, latência e desempenho.
Como Implementar com Eficiência
Escolha o Solver Certo: Avalie APIs por velocidade, precisão e escalabilidade. CapMonster é ideal para volume alto e projetos sensíveis.
Otimize o Framework de Scraping: Use Puppeteer ou Selenium com comportamentos aleatórios.
Gerencie Proxies: Gire IPs residenciais e monitore falhas.
Siga Padrões Éticos: Respeite as leis e a privacidade dos dados.
Monitore e Adapte: Acompanhe métricas e ajuste para novos desafios.
Com a evolução dos CAPTCHAs, usar IA, redes descentralizadas e arquiteturas híbridas manterá seus pipelines atualizados. A automação de CAPTCHA para big data permite inovação mais rápida, vantagem competitiva e crescimento orientado por dados.
Pronto para otimizar seu fluxo de dados? Experimente o CapMonster Cloud e libere todo o potencial do scraping automatizado em larga escala.
NB: Por favor, observe que o produto é destinado à automação de testes exclusivamente em seus próprios sites e em recursos para os quais você possui autorização legal de acesso.